AIクローラーはJavaScriptを実行しない。CSRで実績数値が読まれなかった話
こんにちは。Paidデザインチームのオオイです。
近年、Webマーケティングや開発の現場では、従来の「SEO(検索エンジン最適化)」に並び、ChatGPTやClaude、PerplexityなどのAI検索に自社サイトを正しく読み取ってもらう「AIO(AI検索最適化)」、「LLMO(大規模言語モデル最適化)」、「GEO(生成エンジン最適化)」という考え方が広まってきています。
検索ユーザーがGoogleの検索結果リンクをクリックせず、AIの生成する要約や回答だけで情報収集を完結させる「ゼロクリック検索」が増える中、自社サイトのトラフィックやコンバージョンを守るためには、「AI検索の出力ソースとして正しく引用・表示されること」が重要になってきています。
そんな中、Paidに掲載している実績数値について、主要なAIにURLを渡して読み取らせる検証をしたところ、フロントエンド実装で見落としがちな点に気が付きました。
今回試したAI(Gemini、ChatGPT、Claude、Perplexity)の中では、Gemini以外のAIはJavaScriptを実行した後の画面(再レンダリング後のDOM)をまったく見ていないということです。
補足:この記事での「AIクローラー」について
今回の検証はチャット画面にURLを貼って読ませる形なので、実際にページを取りに来ているのは学習用のクローラー(GPTBotなど)ではなく、ユーザーの操作をきっかけにページを取得するフェッチャー(ChatGPT-User、Claude-User、Perplexity-Userなど)です。この記事では両方をまとめてざっくり「AIクローラー」と呼んでいます。
1. きっかけ:なぜAIによって「実績数」の回答が異なるのか?
「Paidの公式サイトのURLだけをAIに渡した場合にどんな情報が返ってくるのか?」という疑問からスタートしました。
その検証中に、一部のAIがサイトに載っている会社情報を正確に読み取れていないことに気が付きました。
- Gemini:「5,500社以上です」と正確に回答
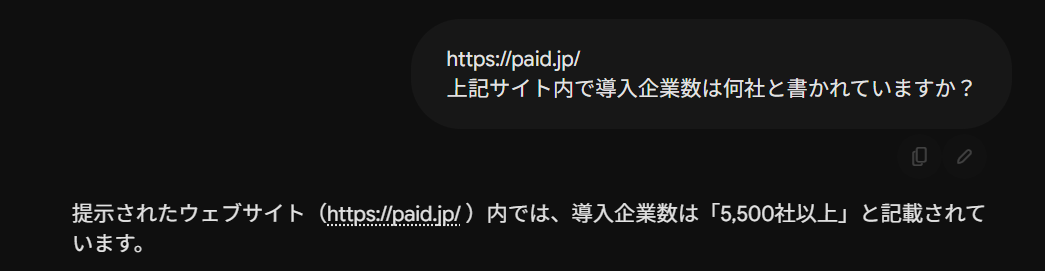
- Claude / ChatGPT / Perplexity:「aaaa社です」または「正確な数値を読み取れません」と回答(キャプチャはClaudeとのチャット)
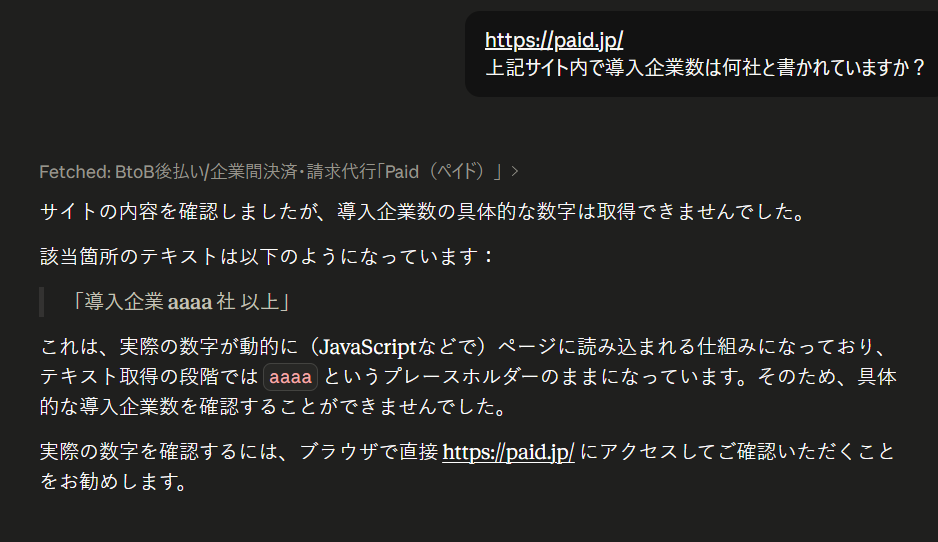
「aaaaって?」と思い、ソースコードを確認して納得しました。該当部分は以下のような実装になっていたのです。
<!-- サーバーから返ってくる初期HTML(当時) -->
<div class="sa number"><span class="n01">導入企業</span>
<span class="n02 json_company">aaaa</span>
<span class="n03">社</span>
<span class="n04">以上</span></div>
<script src="/js/company-data.js"></script>
Paidでは、導入企業数・郵便番号・本社住所・資本金といった会社情報を1つの共通JSファイルにまとめていました。HTML側にはプレースホルダーとして aaaa を置いておき、ページ読み込み後にJSが json_company クラスの要素を見つけて 5,500 に書き換える(再レンダリングする)仕組みです。これは、会社情報が変わったときにJSを1ファイル直せば全ページに反映される、という運用上のメリットを狙った実装でした。
Googleのインフラをバックボーンに持つGeminiは「再レンダリング後のDOM」が読めているのに対し、他のAIは「JS実行前の生のHTMLソース」しか読んでいないということが分かりました。
なお、Paidトップページはこの後リニューアルしたため、現在は導入企業数の表示自体がなくなっています。同じ仕組みで数字を出していた導入事例などのページには今も残っていて、後述の修正を入れたので、現在は生HTMLに最初から「5,500」が入っています。
2. 【検証】ハードコードやSSRのサイトはどうなる?
「じゃあ、他のコーディング技術やシステムで作られたサイトならどうなのか?」気になったので、異なるアーキテクチャのサイトでも検証を行いました。
幸いにも自社の他サービスがそれぞれ違うアーキテクチャだったので検証は容易でした。
パターン①:静的なハードコード(URIHOなど)
HTMLのソースコード自体に最初から 3,000社 のように数字が直接書き込まれているサイト。
結果: Geminiはもちろん、ChatGPTやClaudeでもテキストを直接拾えるため、問題なく正確な数値を読み取れました。
パターン②:サーバーサイドレンダリング / SSR(スーパーデリバリーなど)
JSPなどを用い、サーバー側でデータベースの最新数値をHTMLに結合して出荷しているサイト。
結果: こちらもクライアントサイドでのJS実行を必要としない(最初からHTMLにデータがある)ため、プロンプトの指示次第でGemini以外のAIでも一発で正確な数値を読み取ることができました。
この検証から、AIがサイトを読み取る際の境界線が見えてきました。
3. 海外の調査レポートも「AIクローラーはJSを実行しない」
「今回のAIの回答がたまたまそうだっただけでは?」と思うかもしれませんが、実は海外のフロントエンドプラットフォーム「Vercel」と、技術的SEOのコンサルティング会社「MERJ」が2024年12月に公開した共同調査レポート「The rise of the AI crawler」でも、同じことがデータで示されています。Vercelのネットワーク上で1か月に観測したGPTBotのアクセスだけで5億6,900万回という規模の調査です。
The results consistently show that none of the major AI crawlers currently render JavaScript. This includes:
- OpenAI (OAI-SearchBot, ChatGPT-User, GPTBot)
- Anthropic (ClaudeBot)
- Meta (Meta-ExternalAgent)
- ByteDance (Bytespider)
- Perplexity (PerplexityBot)
(意訳)主要なAIクローラーは、OpenAI・Anthropic・Meta・ByteDance・Perplexityのいずれも、現時点ではJavaScriptをレンダリングしていない。
The data indicates that while ChatGPT and Claude crawlers do fetch JavaScript files (ChatGPT: 11.50%, Claude: 23.84% of requests), they don't execute them.
(意訳)ChatGPTとClaudeのクローラーはJavaScriptファイルを取得はしている(リクエスト全体のうちChatGPTは11.50%、Claudeは23.84%)が、実行はしていない。
面白いのは「取得はするが実行はしない」という点です。JSファイル自体はダウンロードしているのに、それを動かして画面を組み立てるところまではやっていません。世界中のWebサイトのJSを毎回実行してレンダリングするのは相当なインフラコストなので、現状はそこを割り切っているのだと思われます。
一方で同レポート内にはレンダリングできるクローラーの名前も挙がっています
Google's Gemini leverages Googlebot's infrastructure, enabling full JavaScript rendering.
AppleBot renders JavaScript through a browser-based crawler, similar to Googlebot.
(意訳)GoogleのGeminiはGooglebotの基盤を活用しており、JavaScriptを完全にレンダリングできる。AppleBotもGooglebotと同様、ブラウザベースのクローラーでJavaScriptをレンダリングする。
例外がGeminiです(AppleBotは今回の検証では試していません)。Geminiは、Googleが長年運用してきた「JavaScriptレンダリングインフラ(WRS: Web Rendering Service)」をそのまま活用できるため、人間がブラウザで見ているのと同じ「再レンダリング後の最終DOM」を処理できます。
これはGoogleのMartin Splitt氏も、2025年5月に公開された鈴木謙一氏(Faber Company)とのインタビューで「WRSは、Google内のさまざまなシステムで利用可能なサービス」だと述べていて、GooglebotとGeminiが同じレンダリング基盤を使っていることを認めています(ミエルカマーケティングジャーナルの記事)。
4. どう直したか:JSで差し込むのをやめて、生成時にHTMLに焼き込む
原因が分かったので修正です。といっても、サイトをSSRフレームワークに作り替えたわけではありません。
シンプルに、「会社情報をブラウザのJSで差し込む」のをやめて、「ページを生成するタイミングでHTMLに書き込む」ようにしただけです。
もともと共通JSにしていた理由は「会社情報は複数リポジトリ・複数ページで使っていて、1か所直せば全部に反映されてほしい」でした。このメリットは残したいので、マスターは1ファイルのまま、配り方だけを変える方針にしました。
仕組み
- 会社情報は
company-data.jsonに持つ(ここだけが正) - 更新したら
node scripts/generate-company-data.jsを実行する - スクリプトが各リポジトリのページに値を書き込む。出し方はページの種類ごとに違います
* 静的HTML(LP):<span class="json_company">5,500</span> のように文字列を直接書き込む。クラス名は、スクリプトが置換対象を見つけるための目印として残しています
* JSP:生成した company_data.jsp をincludeして ${jsonCompany} で出す
4. 差分が出たリポジトリでcommit & push
<!-- 修正後の初期HTML -->
<span class="n02 json_company">5,500</span>
<%-- JSPの場合 --%>
<%@ include file="company_data.jsp" %>
...
<span class="n02">${jsonCompany}</span>
これで、サーバーから返ってくる時点でHTMLに「5,500」が入っています。確認はブラウザのデベロッパーツールで「JavaScriptを無効化」してページを開き、それでも5,500と表示されればOKです。
更新のたびにコマンド実行とコミットが必要にはなりますが、会社情報の更新頻度を考えれば大した手間ではありません。手順はWikiに残して他のメンバーも同じ作業ができるようにしました。
ポイントは、フレームワークの移行はゼロということです。JSPもjQueryもそのまま。「AIに読ませたい値を初期HTMLに入れる」だけで解決しました。
まとめ
今回の検証を通じて、「AI検索はブラウザと同じ画面を見ているわけではない」ということを実感しました。
- Gemini ➔ 再レンダリング後のDOMが読める
- ChatGPT / Claude / Perplexity ➔ JS実行前のHTMLしか読めない(JSファイルは取得するが実行しない)
ログイン前のページ(トップページ、LP、価格表、実績数値、FAQなど)で大事な値をJSで差し込んでいると、Googleには見えても、ChatGPTやClaude、Perplexityからは空(または初期値のまま)に見えてしまいます。
「せっかく最新の実績値をサイトに反映したのに、AIに質問すると古いデータのまま回答される」
「AI検索のソースとして自社サイトが全く引用されず、トラフィックが減った」
という状態は、こうしたことが原因で起きている可能性があります。
みなさんの管理しているサイトの「ログイン前ページ」、生HTMLの状態でコンテンツがちゃんと入っていますか?
一度 curl で叩くか、ブラウザのデベロッパーツールでJavaScriptを無効化して確認してみることをおすすめします!
ラクーンホールディングスでは、新しい仲間を募集しています!
少しでも興味を持った方は、ぜひ採用情報をご覧ください!